目录
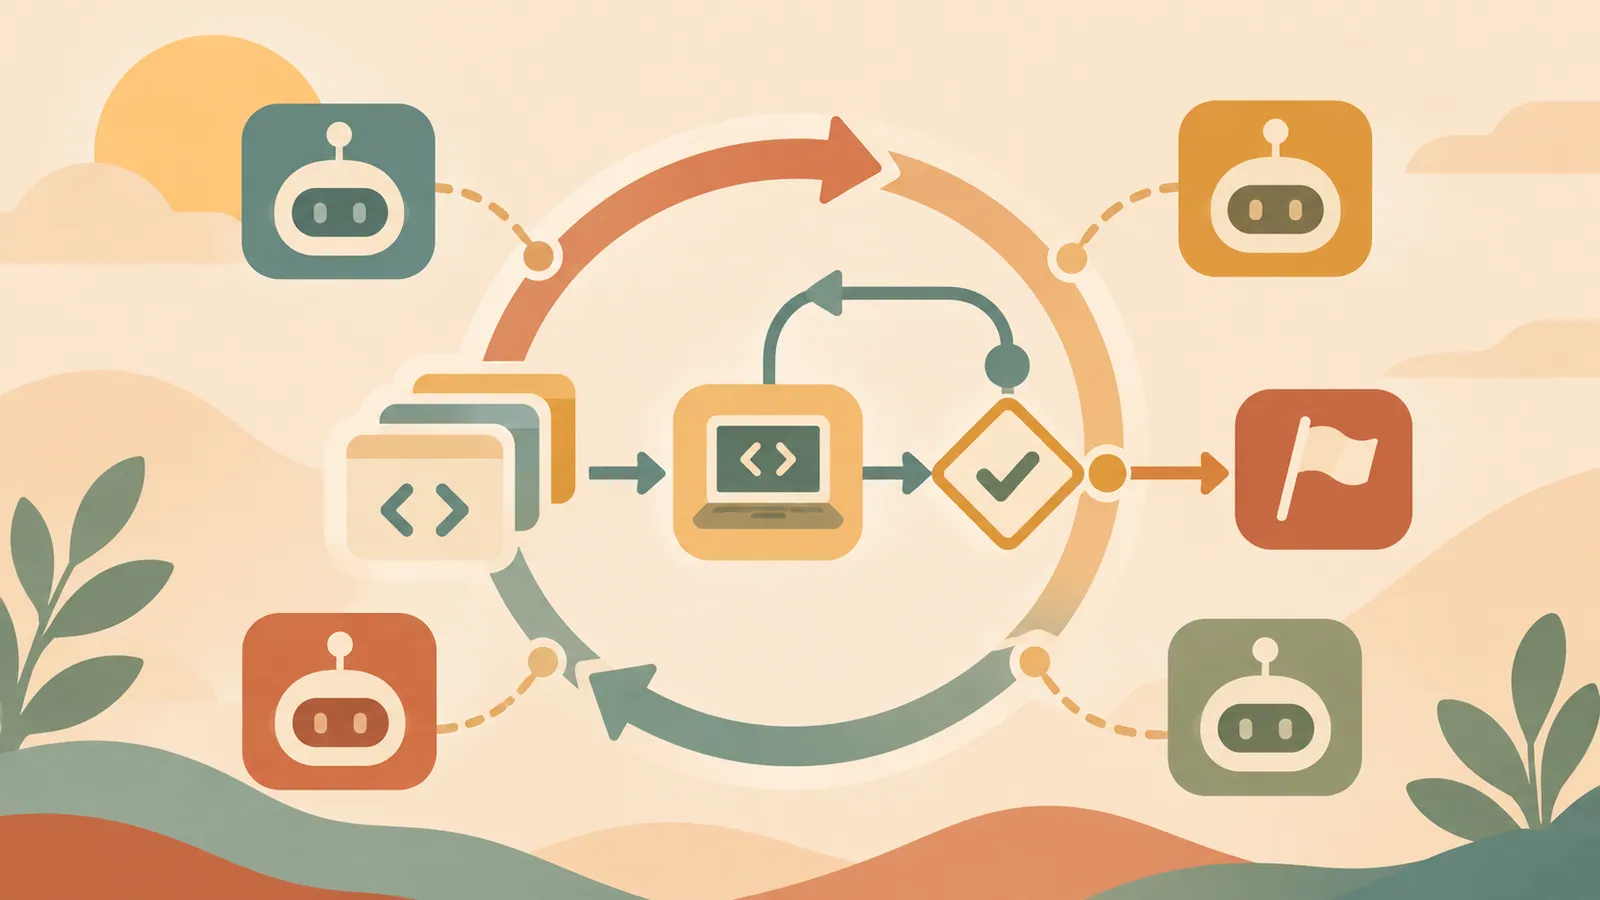
Sanabi(@0xSanabi)的帖子想传达的是,不要只用Claude Code回答一次性问题,而要建立让多个智能体执行任务、检查结果并继续推进的机制。首先值得借鉴的不是50个智能体的配置,而是具备执行、检查和停止条件的小循环。
要点#
- Sanabi正在推介一场工作坊,介绍可运行50多个Claude智能体的运行框架(harness)。
- 帖子的主线是“模型→工具→运行框架→闭环→自我改进系统”这几个阶段。
- 据帖子介绍的研究,对36,487个代码仓库的调查发现,循环往往有启动条件,却缺少检查机制、状态和终止条件。
- 比较现实的做法是先用两个左右分工明确的智能体试运行,衡量质量和成本后再增加数量。
解读帖子的主张#
Sanabi的帖子援引一位Anthropic工程师的话称:“99%的人像用Google一样使用Opus 5.5,而最顶尖的1%在搭建运行多个智能体的框架。”帖子还介绍了由担任Chief或PM的智能体统筹全局的配置,以及一场26分钟的工作坊。
这个比例和“以最低成本取得最大成果”的表述,适合当作帖子的宣传用语来看。仅凭这里的信息,无法确认比例的计算方法或工作坊的效果。值得关注的不是数字有多大,而是不止于向模型下达指令,还要设计工具和执行规则的思路。
运行框架是工作的组织方式#
运行框架是一个执行环境,整合了交给智能体的任务、可用工具、共享状态和结果判定方法。分工时,可以让一个智能体修改代码,另一个阅读差异并检查是否满足条件。担任Chief或PM的智能体则负责拆解需求并分派任务。
不过,增加智能体并不会自动提速。如果任务重复,或同时修改同一个文件,协调成本就会增加。先分成“修改负责人”和“检查负责人”两个角色,明确每项任务由谁负责。
为循环设置出口#
帖子引用的研究标题是“Harness, Loops, Graphs: What 217 Real Agent Loops Are Missing”。据帖文介绍,该研究调查了36,487个代码仓库,发现循环虽然有启动条件,却缺少检查机制、状态和终止条件。这是帖子对研究的概述,详细统计方法仍需查阅原文。
实现时,除了启动处理的条件,还要确定如何判定成果、失败时如何处理,以及何时停止。例如,规定“测试不通过时只重试修复一次,仍然失败就交回给人”,就能降低无限重试的风险。
从小处搭建并衡量#
第一次实验,将范围限定为一个小任务。先确定输入、完成条件和尝试次数上限,再让负责执行和检查的智能体运行。如果是修改代码,同时限制目标文件和允许执行的命令,会更容易追踪结果。
比较四项指标就足够:完成率、检查发现的缺陷、每项任务的耗时和费用。还要与单个智能体处理的情况比较。如果费用和检查工作量增加,完成率却没变化,就没有太大理由增加智能体。
自我改进从记录开始#
“自我改进系统”这个词,可能让人想到智能体自行改写机制的情景。但没有必要一开始就把自动修改也交给它。记录失败的指令、修改次数和检查发现的问题,再由人决定下次运行要调整哪里,也能为改进提供依据。
如果要进入自动更新提示词或配置的阶段,就要记录修改内容,并确保能恢复到之前的配置。即使看起来有所改善,在其他类型的任务上也可能退步。最好固定评估任务,在相同条件下比较修改前后的表现。
下一步#
从手头选一个小任务,按“1个执行智能体、1个检查智能体、最多重试1次、失败时停止”的条件试运行,再与单独执行时的耗时、费用和缺陷数量比较。
来源: https://x.com/0xSanabi/status/2118412839081988342
目录