目录
当应用程序需要预定义的答案时,例如咨询应转交的部门或紧急程度评分,可以使用决策模型。Hugging Face 的决策接口无需生成文本回复,即可返回带类型的结果和概率,以一致的方式评估预定义选项。
要点#
- 定义输入状态和允许的答案,根据返回的概率控制应用程序的行为。
- 选项使用
choice,有序等级使用score,是/否的概率使用noul。 - 支持该接口的 Transformers 和 llama.cpp 实现提供
/v1/systemone端点。 - 在自动化决策前,使用自己的数据验证准确率、概率校准情况和延迟。
何时使用决策模型#
决策模型适用于应用程序预先知道候选答案的任务。例如,分派支持工单、确定审核优先级、判断消息是否要求退款,以及选择可用工具。
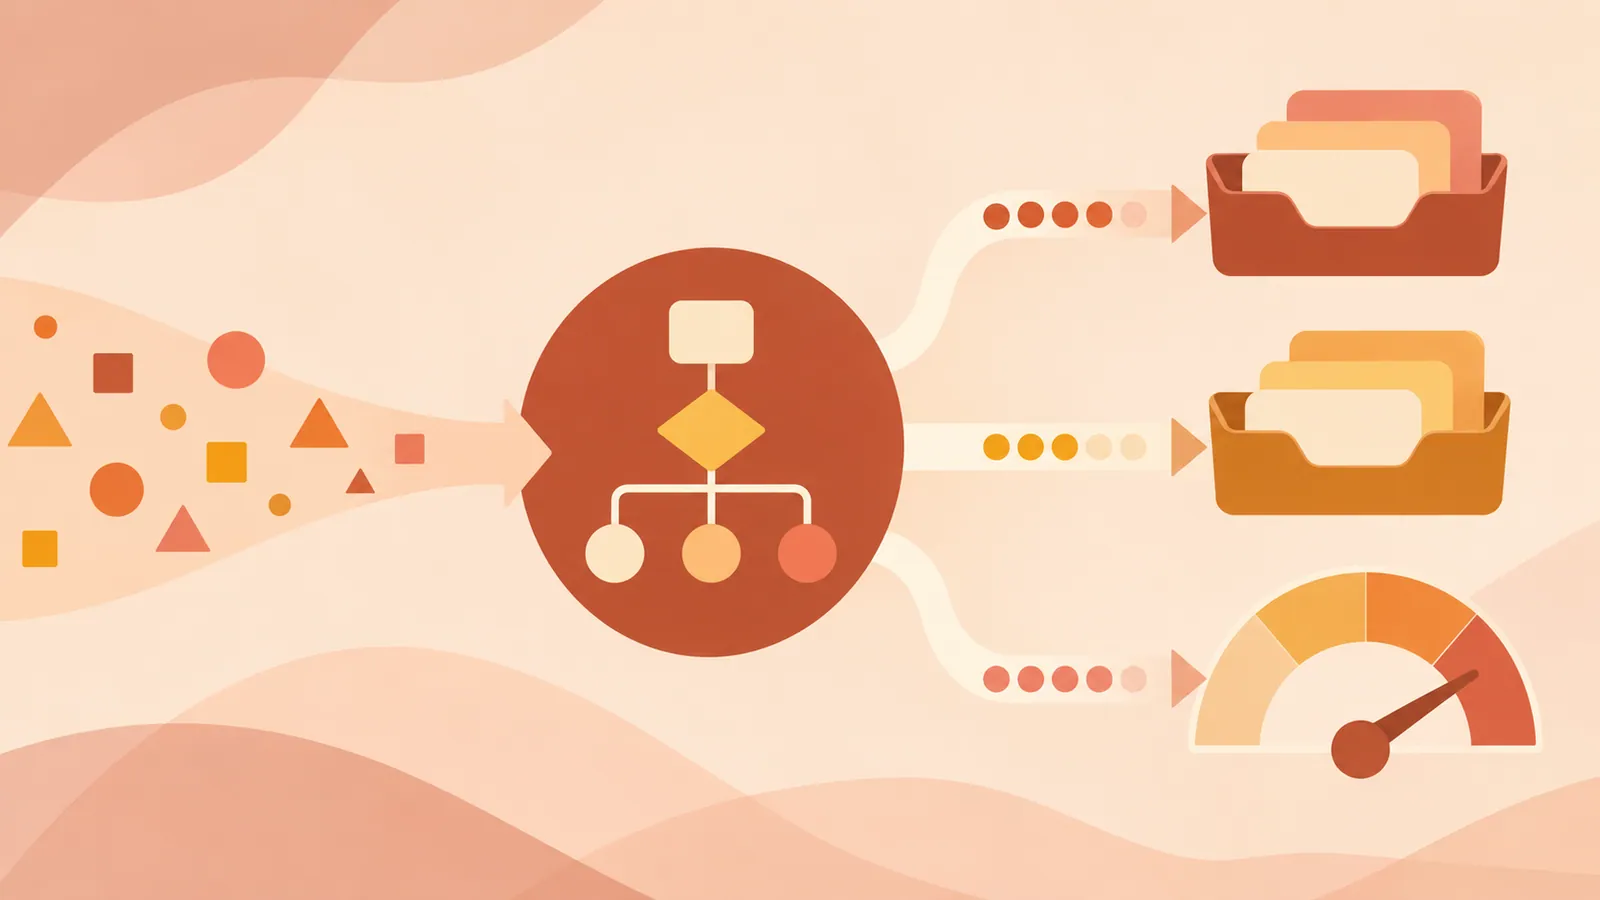
接口很简单:状态 + 问题 + 允许的答案 → 判断 + 概率。一次请求可以包含针对同一输入的多个具名问题。应用程序会收到可直接使用的结构化值。
这与分类有一定重叠。固定标签分类器早已能够返回概率,零样本分类器也早已支持在推理时指定标签。实际区别在于,多种问题形式可以使用同一个接口。对于解释、回复草稿等需要自由形式输出的任务,仍应使用文本生成。
定义答案类型#
选择适合判断任务的基本类型。明确描述各个类别,并充分区分有序等级,让审核人员能够一致地应用这些标准。
| 基本类型 | 定义内容 | 返回内容 | |---|---|---| | choice | 带名称和描述的选项 | 选中的选项及各选项的概率 | | score | 有序的标准列表 | 等级索引的期望值及其概率分布 | | noul | 用是/否回答的问题 | 模型估计答案为“是”的概率 |
如果紧急程度分为 0、1、2 级,概率分别为 0.02、0.26、0.72,则评分为 1.70:0 × 0.02 + 1 × 0.26 + 2 × 0.72。这不是选中的类别,而是基于分布的平均值。如果 noul 的值为 0.92,则“是”的概率为 92%。这一概率是否足以采取行动,由应用程序判断。
执行第一个请求#
在安装了受支持版本的 Transformers 的环境中,加载决策管道并定义一个问题。此示例遵循 Hugging Face 于 2026 年 11 月 10 日发布的公告中介绍的接口。运行前,请确认软件包的支持情况和模型的硬件要求。
from transformers import pipeline

decide = pipeline(
    "decision",
    model="autotrust/GEV-26B-Decide",
)

result = decide({
    "state": "二重に請求されたので返金してほしいです。",
    "questions": {
        "department": {
            "type": "choice",
            "instructions": "どのチームが対応すべきですか?",
            "criteria": {
                "billing": "支払いと返金",
                "technical": "バグと技術的な問題",
                "sales": "料金とサブスクリプション",
            },
        },
    },
})

print(result)
将结果接入工作流前,先检查选中的部门和完整分布。用有代表性的示例确认分派标准有效后,再添加有关紧急程度或退款的问题。能够在推理时添加类别,使接口具有灵活性,但这本身并不意味着模型能可靠地识别该类别。
通过通用 API 提供服务#
对于 HTTP 集成,支持该接口的 Transformers 服务实现和 llama.cpp 实现均使用 /v1/systemone。请求包含 state 和 questions,模型选择取决于服务器配置。可以通过 Hugging Face Hub 上的 decision-model 标签搜索支持的模型。
通用规范可以减少更换模型或推理引擎时的集成工作。但这并不保证预测结果、支持的模态和性能完全相同。Transformers 通过评估答案标签的 logits 而不生成回复,也能让支持的自回归模型使用此接口。
即使不生成输出 token,推理成本也不会归零。输入处理、模型大小、问题数量和实现方式仍会影响延迟和内存占用。请测量完整请求,并与现有分类器或提供结构化输出的 LLM 进行比较。
自动化前检查置信度#
即使概率分布集中,判断仍可能出错。文档中针对 choice 定义的置信度,以均匀分布为基准对最大概率进行归一化。如果有 4 个选项,最高概率为 0.85,则置信度为 0.80。这是衡量集中程度的值,并非经过验证的准确率。不要假定同样的计算也适用于 score。
部署前,请检查以下四点。
- 使用来自实际业务的带标签示例,测量判断的准确率。
- 检查校准情况。预测概率在 0.90 附近时,正确率应约为 90%。
- 纳入含糊的输入,以及不符合任何允许答案的情况。
- 在相同部署条件下,比较延迟和资源使用量。
根据结果,设置需要人工审核的阈值。例如,自动分派工单和批准退款,后果的重要程度不同。不能仅凭检测到退款请求就批准付款。
下一步#
使用 100 条实际支持工单创建带标签的评估集,在启用自动分派前,将部门分派准确率和延迟与当前系统进行比较。
来源: https://huggingface.co/blog/decision
目录