目次
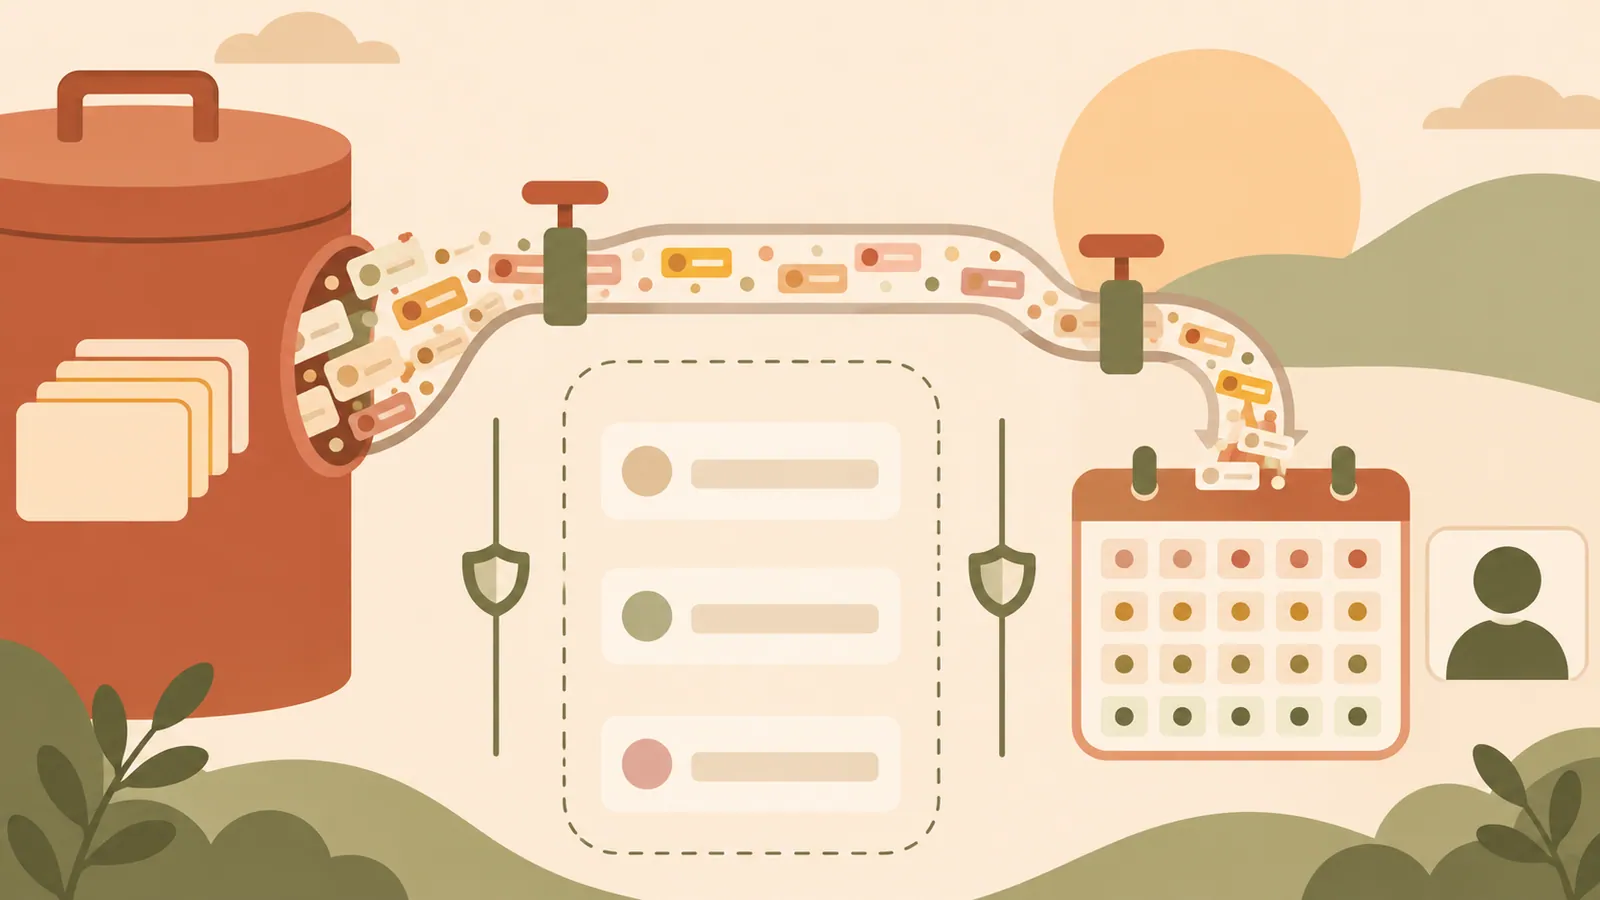
mixi2のXアーカイブインポーターは、タイムラインへの配信、通知、連続投稿日数の更新を抑えながら、過去の投稿をカレンダーとプロフィールに取り込みます。技術面での主な課題は、何千件もの投稿の作成に伴う副作用を制御しつつ、記録を保存することでした。
要点#
- インポートした投稿はXでの元の投稿日時を保持し、カレンダーの対応する日付に表示されます。
- 大容量のアーカイブはS3に直接アップロードし、準備処理と投稿作成を非同期で進めます。
- 投稿データは最大1,000件のチャンクに分割し、インポートごとに1チャンクずつキューに投入します。
- 重複防止と、成功・失敗・スキップ件数の個別集計により、再試行を管理しやすくします。
インポートの意味を定義する#
インポートした投稿は、過去の記録として扱うべきです。mixi2ではカレンダーとプロフィールに表示しますが、フォロワーのホームタイムラインへの配信、投稿通知の送信、ユーザーの連続投稿日数の加算は行いません。検索にも表示する想定ですが、投稿日時の扱いには追加対応が必要でした。
インポーターは返信とリポストを除外します。引用投稿はユーザー自身の本文とリンクに変換し、元の会話構造は再現しません。Xのメンションは通常のテキストのまま残します。mixi2で同じユーザー名を使っていても、別人の可能性があるためです。有効なメンションに変換すると、誤った相手に通知するおそれがあります。
これらのルールによって、実用的な境界が定まります。既存のストレージやメディア処理を再利用しつつ、投稿作成によって起きるすべての動作を明示的に制御するのです。投稿日時を過去に設定するだけでは、通知やフィードへの配信は防げません。
アーカイブを読み込み、正規化する#
対象となるアーカイブファイルは、data/tweets.js、tweets-part*.jsに一致する各ファイル、data/tweets_media/内の添付ファイルです。拡張子は.jsですが、投稿ファイルの中身はJavaScript変数に代入されたJSONデータです。代入部分のラッパーを取り除けば、レコードをJSONとして解析できます。
各レコードにはXの投稿ID、投稿日時、本文が含まれます。本文には正規化が必要です。関連するURLフィールドを使ってt.coリンクを展開し、&などのHTMLエンティティをデコードします。開発中に調べた画像では、投稿IDとメディアURLのファイル名を組み合わせることで、対応するアーカイブ内のファイルを特定できました。
動画では、候補となるURLとZIP内に実在するファイルを照合する必要があります。XでGIFとして表示される添付ファイルの一部は、アーカイブではMP4ファイルになっています。そのため、表示上のラベルで形式を決めつけず、実際に含まれるファイルを調べる必要があります。
大容量ZIPを段階的に処理する#
この設計では、数十GBのアーカイブを想定しています。出典には、別々のダウンロードが推定50 GBと15 GBだったというユーザー報告があります。これは大容量ファイルに備える根拠であり、Xのアーカイブの公式なサイズや分割を保証するものではありません。
処理は次の4段階で進みます。
1. クライアントがマルチパートアップロードでZIPをS3に直接アップロードし、失敗したパートを再送できるようにします。 2. アップロード完了イベントで準備処理用ワーカーを起動し、ユーザーが画面を閉じた後も処理を続けます。 3. ワーカーはS3 FilesとGoのzip.OpenReaderでZIPにアクセスし、アーカイブ全体をアプリケーションのメモリに保持せず、必要なエントリを読み込みます。 4. 抽出したメディアと正規化した投稿データをS3に保存し、投稿データは各ファイル最大1,000件のJSONLに分割します。
JSONLの各行は1件の投稿を表します。チャンクに分割することで、1ジョブあたりの投稿作成量と再試行の範囲を抑えます。最初は先頭のチャンクだけをキューに投入し、完了したら次を投入します。これにより、1件の大規模なインポートの全チャンクが共有キューを埋めるのを防ぎ、全体の同時実行数はワーカー側で制御します。
制限の範囲内で記録を残す#
出典では、mixi2の文字数制限は149.3文字とされています。一部のXの投稿はこの制限を超えるため、本文を短縮し、省略記号と元の投稿へのリンクを追加します。どちらも追加後の文字数が取り込み先の制限内に収まる必要があります。
メディアには別途、サイズと長さの制限があります。添付ファイルが事前に確認できる条件を満たさない場合、インポーターは条件を満たす本文とメディアを残し、元の投稿へのリンクを追加します。取り込めない添付ファイルが複数あっても、リンクの追加は1投稿につき1回だけです。
この代替処理により、省略したコンテンツへのアクセスを残せますが、元のXの投稿が引き続き閲覧できることが前提です。処理中のメディア変換エラーは、既知のサイズや長さの制限と同じ扱いにはせず、失敗として処理します。
安全に再試行でき、結果が分かるようにする#
インポーターは、各X投稿IDと作成されたmixi2投稿IDの対応を記録します。再試行時にはその対応を確認し、同じユーザーがすでにインポートした投稿をスキップします。投稿作成と対応情報の挿入を1つのデータベーストランザクションで実行し、保存済みの投稿にインポート記録がない状態を防ぎます。
1件の投稿が失敗しても、それ以降の投稿はすべて停止しません。成功、失敗、スキップを個別に集計し、最後のチャンクの処理後に結果を報告します。そのため、インポートが最後まで進んでも、全レコードが成功したとは限りません。
投稿日時の確認は、後続のシステムにも及ぶ必要があります。出典によると、インポートした投稿を元の日付に沿って検索結果に配置するには、まだ対応が必要でした。カレンダーとプロフィールの並び順が正しくても、検索の並び順まで正しいとは限りません。
次のステップ#
アーカイブインポーターを作る前に、インポートした投稿の日時、フィード、通知、検索、アクティビティのカウンターに関する挙動を表にまとめましょう。
出典: https://zenn.dev/mixi/articles/bcf2363e83b0a2
目次